服务器数据处理与数据处理服务 从底层架构到业务赋能
在数字化时代,数据已成为与土地、劳动力、资本、技术并列的生产要素。原始数据本身是沉默的——只有当它经过采集、清洗、转换、聚合、分析之后,才能转化为洞察与决策。这一过程的核心载体,便是服务器数据处理;而将这一能力产品化、服务化,则构成了蓬勃发展的数据处理服务产业。
一、服务器数据处理:数据价值链的引擎
服务器数据处理,是指在服务器端对数据进行的一系列操作,包括数据的接收、解析、过滤、排序、聚合、关联、统计以及持久化。与客户端处理相比,服务器端处理具备三大不可替代的优势:
- 集中式计算与存储:服务器拥有更强的CPU/GPU算力、更大的内存与磁盘阵列,能够处理TB乃至PB级数据集。
- 多源异构整合:不同系统、格式、协议的数据在服务器端汇聚,通过ETL(抽取-转换-加载)或ELT管道统一为可分析资产。
- 可靠性与并发性:通过集群、负载均衡、分布式文件系统(如HDFS、Ceph)和消息队列(如Kafka),保证高并发下数据不丢、不重、不乱序。
典型处理模式
- 批处理:适用于离线场景,如日终报表、历史数据挖掘。代表框架:Hadoop MapReduce、Spark。
- 流处理:面向实时场景,如风控预警、实时推荐。代表框架:Flink、Storm、Kafka Streams。
- 交互式处理:SQL on Hadoop、ClickHouse、Doris等,支撑即席查询与OLAP分析。
- 内存计算:将热数据驻留内存(如Redis、Ignite),大幅降低延迟。
核心组件与流程
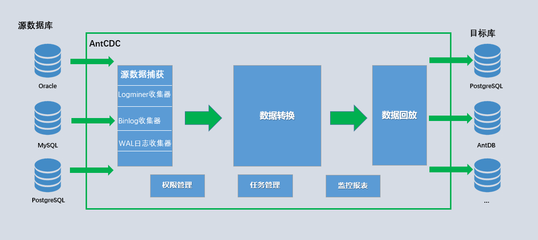
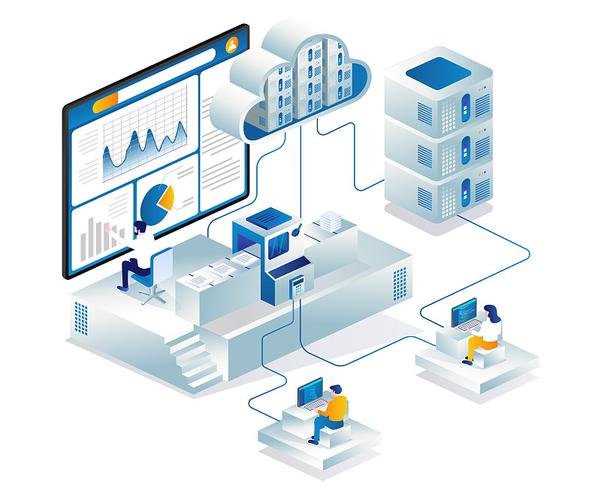
一个典型的服务器数据处理流程包含:数据接入(API、日志、CDC)→ 消息缓冲 → 计算引擎 → 存储(数据湖/仓/库)→ 服务接口。其中,数据质量是生命线,脏数据、缺失值、重复记录若不处理,后续所有分析都会失真。因此,服务器端常内置规则引擎进行校验、去重与标准化。
二、数据处理服务:从自建到服务的范式转移
早期,企业大多自建服务器集群和数据处理流水线,但面临成本高、运维复杂、弹性差等痛点。随着云计算成熟,数据处理服务(Data Processing as a Service, DPaaS)应运而生,将底层能力封装为可计费、可弹性伸缩的API或托管平台。
服务形态
| 类型 | 说明 | 代表产品 |
|------|------|----------|
| 基础设施级 | 提供虚拟服务器、容器、存储 | AWS EC2、阿里云ECS、Kubernetes |
| 平台级 | 托管大数据引擎,按需启停 | AWS EMR、阿里云MaxCompute、Databricks |
| 应用级 | 特定场景的API,如OCR、语音转写 | 百度AI、腾讯云数据万象 |
| 管道级 | 可视化数据集成与调度 | Airflow托管版、阿里云DataWorks |
关键能力
- 弹性伸缩:根据数据量自动增减计算节点,成本随用随付。
- 无服务器化(Serverless):用户无需管理服务器,如AWS Lambda、函数计算处理事件流。
- 托管运维:自动打补丁、备份、监控、故障转移。
- 安全合规:传输加密、静态加密、细粒度访问控制、数据脱敏。
典型应用场景
- 电商实时推荐:用户点击流经Kafka→Flink实时特征计算→Redis/向量数据库→推荐API返回结果。
- 物联网设备分析:海量传感器数据经消息队列→时序数据库→降采样与异常检测。
- 金融风控:交易流水实时关联黑名单、行为序列,百毫秒内输出风险评分。
- BI与报表:夜间ETL把业务库同步到数据仓库,早晨生成管理层看板。
三、选型与架构建议
面对批流混存、湖仓一体的趋势,企业构建服务器数据处理与选用数据处理服务时,可参考以下原则:
- 匹配时效性:T+1分析可选批处理,秒级告警必选流处理。
- 评估成本模型:自建适合稳定大规模负载,云服务适合波动型、创新试验型负载。
- 避免供应商锁定:优先选用支持开放格式(Parquet、ORC、Iceberg)和标准SQL的服务。
- 可观测性先行:没有监控和血缘,再先进的管道也会变成黑盒。
- 安全内嵌:从接入到输出,全链路嵌入权限与加密。
数据治理不可忽视。元数据管理、数据目录、生命周期策略决定数据处理能否长期可持续。单纯堆砌算力而忽视治理,往往造成“数据沼泽”。
四、未来展望
服务器数据处理将呈现三大趋势:
- Serverless化加深:用户只需专注UDF(用户自定义函数)与逻辑,底层全由平台调度。
- AI增强处理:通过大模型自动生成ETL代码、智能推荐分区与索引,或直接在数据上运行推理。
- 湖仓一体与流批一体:单一存储同时支持流式与批式读写,消除数据孤岛。
数据处理服务也正从“工具”进化为“智能体”——自动发现数据、理解Schema、推荐清洗规则、执行编排。对于开发者而言,要么深耕底层服务器数据处理的内核(如调度、容错、Shuffle优化),要么善用上层数据处理服务快速交付业务价值。两条路径各有千秋,但最终都将服务于同一个目标:让数据可信、可用、可见。
无论你是运维工程师、数据工程师还是业务分析师,理解“服务器数据处理”不仅是技术能力的底座,也是设计高可靠数据系统的起点;而善用“数据处理服务”,则能极大加速从数据到价值的旅程。选择并非非此即彼,混合架构与按需迁移,常在成本与敏捷之间找到最佳平衡。